Nubi es el nombre que usamos para los modelos internos que leen los comentarios de los pulsos. Hoy hay dos en preview: nubi-moderation-preview, que clasifica comentarios, y nubi-entity-preview, que busca datos personales para taparlos.
No es un solo modelo. Combina tres piezas: una búsqueda de ejemplos parecidos ya etiquetados, un modelo que ordena esos ejemplos por relevancia, y un modelo de lenguaje que lee el comentario y responde preguntas concretas sobre cada tarea. Las tres opiniones se juntan en un puntaje por tarea, y los umbrales se eligieron solo con los casos de desarrollo, antes de mirar la prueba final.
Lo corrimos una vez con los modelos reales sobre 424 comentarios sintéticos en español rioplatense: 212 para ajustar y 212 guardados aparte como prueba final, que no se tocaron hasta el final. Los comentarios y sus etiquetas los escribió un asistente de IA, sin revisión humana independiente.
Tarea
F1 en los 212 de prueba
Moderación
0,905
Sarcasmo
0,715
Riesgo
0,964
Falso o spam
0,958
Para entender si combinar piezas sirve, comparamos contra cada pieza usada sola, sobre el mismo set. Son comparaciones internas, no contra otros sistemas del mercado. La combinación no gana en todo: la búsqueda de ejemplos parecidos sola saca mejor sarcasmo (0,797 contra 0,715) y queda casi igual en moderación (0,896 contra 0,905).
Con estos datos no podemos decir que sea mejor que otras herramientas ni cómo rinde con comentarios reales. El detalle completo, con los casos de riesgo que se le escaparon, está en Cómo medimos nubi-moderation-preview.
Busca datos que identifican a alguien dentro de un comentario: nombres de personas, mails, teléfonos, direcciones, usuarios de redes y números de documento o legajo. Marca cada uno con su posición y su tipo para poder taparlo sin tocar el resto. “La profe Laura nos grita” pasaría a mostrarse con el nombre tapado.
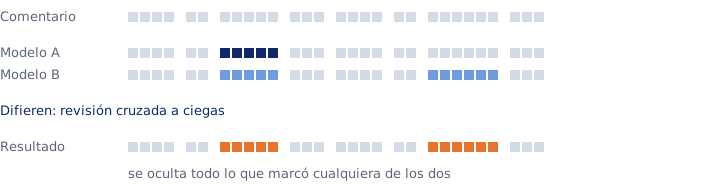
Está construido sobre LACE, nuestra arquitectura para que varios modelos se revisen entre sí. Dos modelos marcan los datos por separado. Si coinciden, se acepta. Si no, cada uno revisa las dos listas a ciegas y hay una sola ronda para reconciliar. Ante la duda se oculta, y todo lo que cualquiera de los dos marcó queda tapado.
Eso quiere decir que a veces va a tapar palabras que no hacía falta. Y si ninguno de los dos marca un dato, la revisión no lo va a encontrar.
Solo corrió en pruebas locales con modelos simulados y casos armados a mano, que verifican que la lógica haga lo que tiene que hacer. Todavía no lo corrimos con modelos reales, así que no hay números de precisión. Cuando los tengamos, los publicamos acá.
No reemplazan el filtro actual. Hoy los comentarios pasan por un filtro automático con tres niveles que elige cada organización (Permisivo, Cauteloso o Estricto). No hay personas leyendo comentarios para moderarlos.
No deciden solos sobre riesgo. Si algún día se usan, una señal de riesgo siempre va a una persona, y marcar algo como spam nunca puede tapar una posible crisis.
Cuando un solo modelo resuelve una tarea delicada, sus errores pasan sin que nadie los vea. LACE es la arquitectura que estamos armando para que eso no pase: en lugar de confiar en un modelo, encadena varios y los hace revisarse entre sí.
LACE no es un modelo. Es una forma de organizar varios modelos que sirve para distintas tareas de lenguaje. El nombre viene de Layered Aggregation with Cross-model Evaluation.
1. Extraer, por separado. Dos modelos distintos hacen la misma tarea sobre el mismo texto, cada uno por su cuenta y sin ver lo que hizo el otro. Cada uno puede combinar varias capas propias; lo que importa es que lleguen a una respuesta independiente.
2. Si coinciden, aceptar. Si las dos respuestas son exactamente iguales, se aceptan y el proceso termina ahí, sin llamadas extra.
3. Si difieren, revisión cruzada a ciegas. Cada modelo recibe las dos respuestas, llamadas solo “A” y “B” en un orden mezclado, y opina sobre cada punto: mantenerlo, descartarlo o corregirlo dentro de opciones acotadas. Junto con la opinión elige una razón de una lista cerrada. Ningún modelo sabe cuál respuesta es la suya.
4. Reconciliar una vez y caer en lo seguro. Lo que sigue en discusión vuelve a los dos modelos con la opinión y la razón del otro. Hay una sola ronda de este tipo, sin vueltas infinitas. Si no se ponen de acuerdo, gana la opción segura que se definió de antemano para esa tarea.
Además hay un piso: todo lo que cualquiera de los dos encontró en la primera etapa se respeta en el resultado final, aunque después la revisión lo descarte. Las opiniones de la revisión quedan registradas para estudiarlas, pero no pueden bajar de ese piso.
Un modelo solo se equivoca de formas que no puede ver. Dos modelos distintos tienden a equivocarse en lugares distintos, así que cada uno puede encontrar lo que al otro se le pasó.
La revisión es a ciegas para que ninguno defienda su respuesta por ser suya. Mezclar el orden no garantiza que un modelo nunca reconozca su propio estilo, pero saca la ventaja más obvia.
El piso existe porque dos modelos también pueden ponerse de acuerdo en algo incorrecto. En tareas donde un error es caro, preferimos equivocarnos hacia el lado seguro y pagarlo con algo de precisión.
La primera tarea donde estamos probando LACE es encontrar y tapar nombres y otros datos personales en los comentarios, con nubi-entity-preview. Ahí la opción segura es ocultar: si los modelos no se ponen de acuerdo, el dato se tapa, y todo lo que marcó cualquiera de los dos queda tapado. Lo que ninguno marca, la revisión no lo puede encontrar.
No es la moderación. El filtro que hoy decide si un comentario se muestra es otra cosa: automático, con tres niveles que elige cada organización (Permisivo, Cauteloso o Estricto). No hay personas leyendo comentarios para moderarlos. Tapar datos personales con LACE, si se activa, va a ser un paso aparte.
No reemplaza la niebla. Con menos de 8 pulsos en una semana, el promedio sigue mostrándose como provisorio y sin tendencia.
Probamos la lógica con modelos simulados y casos armados a mano: que las respuestas iguales salteen la revisión, que los desacuerdos lleguen a la segunda ronda, que no haya más de una, y que el piso se respete aunque la revisión diga lo contrario. Todo eso pasa.
Lo que falta es lo importante: correrlo con modelos reales sobre nuestro set de comentarios de prueba, que también es sintético, y medir qué encuentra, cuánto tapa de más y cuánto cuesta. Cuando lo hagamos, publicamos los números acá, buenos o malos.
Para probar alertas tempranas necesitamos historias largas de muchos equipos: semanas de pulsos, bajones, vacaciones, cambios de docente. No las tenemos, y aunque las tuviéramos no usaríamos datos reales de alumnos o empleados para esto. Así que las simulamos.
Este post cuenta la segunda versión de esos datos. La novedad principal es que los equipos ya no viven solos: pertenecen a organizaciones que comparten calendario y problemas.
La primera versión tenía 2.400 equipos, 62.055 semanas y 2.594.379 pulsos. Cada equipo era independiente de los demás.
En una escuela o una empresa eso no pasa. Si se va un docente o hay una reestructuración, varios cursos o áreas bajan a la vez. Y si al separar los datos para la prueba final un curso queda en entrenamiento y su curso hermano en prueba, el modelo “ya vio” el problema compartido y el resultado sale mejor de lo que es.
La versión 2 cambia dos cosas:
Organizaciones. Cada equipo pertenece a una escuela o a una empresa simulada, de 1 a 48 equipos. Cada organización tiene su propio ruido semanal y puede tener eventos que la afectan entera: semana de exámenes, un docente que se va o desgaste acumulado en escuelas; despidos o reorganización y desgaste en empresas. Alrededor del 28% de las organizaciones no tiene ninguno. No todos los equipos sienten el golpe igual: la exposición de cada uno va de 0,35 a 1,45 veces la intensidad del evento.
Separación por organización. Entrenamiento, ajuste y prueba se dividen por organización completa, nunca por equipo ni por semana.
Los equipos se reparten así entre entrenamiento, ajuste y prueba: 350 / 50 / 100 en el chico, 1.650 / 250 / 500 en el mediano y 17.050 / 2.450 / 500 en el grande.
Los tamaños están anidados: el chico es el comienzo exacto del mediano, y el mediano del grande. El mediano y el grande usan exactamente los mismos 500 equipos de prueba; el chico usa 100 de ellos, de 8 organizaciones que cubren todos los rangos de tamaño en escuela y en empresa. Así, si un modelo mejora del mediano al grande, es por tener más datos para entrenar y no porque cambió el examen.
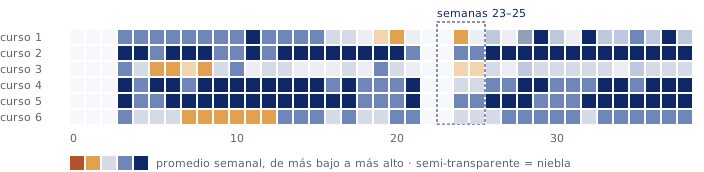
Seis cursos de la misma escuela, 39 semanas. Cada cuadrado es el promedio de una semana. En las semanas 23 a 25 la escuela tiene un evento de “docente que se va”: los seis cursos bajan a la vez, unos más que otros.
En v1 cada uno de esos bajones habría sido un caso aislado.
Hay dos colecciones. La primera tiene los datos “crudos” en cuatro tablas, todas con org_id y org_size:
teams: un registro por equipo (tamaño, fecha de inicio, si es escuela o empresa).
pulses: un registro por respuesta (nivel del 1 al 5, motivo y comentario opcional).
events: los eventos del equipo o de la organización, con inicio, fin e intensidad.
truth: el clima “real” escondido de cada semana y las etiquetas a predecir.
La segunda colección resume todo por equipo y semana: cantidad de respuestas, promedio, desvío, participación, si la semana quedó en niebla, distribución de niveles y motivos, promedios móviles y tendencia. Es lo que vería un panel.
Algunas columnas existen solo para evaluar y no deben usarse como entrada de un modelo: el clima escondido, los efectos asignados, la exposición a los eventos de la organización y si el equipo es “nulo” (sin cambios reales, solo ruido). Por eso los resúmenes semanales no incluyen ninguna señal de los eventos de la organización: un modelo tiene que darse cuenta solo, como pasaría en la práctica.
Las etiquetas son downturn_next_2w y downturn_next_4w: si el clima escondido va a caer en las próximas 2 o 4 semanas respecto del promedio de las cuatro anteriores.
"comment": "En el optativo de programación hice que el botón cambie de color, estoy re orgulloso."
}
{
"team_id": "org-v2-small-train-school-0000-t000",
"week_index": 0,
"created_at": "2026-05-18T10:35:20-03:00",
"level": 4,
"reason": "FAMILIA",
"comment": "En fotografía salimos a buscar reflejos y me divertí un montón."
}
Un evento de organización. La misma escuela tiene semana de exámenes entre las semanas 12 y 20, y cada curso recibe una copia ajustada a su exposición:
Y una semana resumida de un curso de 45 alumnos (recortada, la fila completa tiene más columnas):
Columna
Valor
week_start
2026-06-22
calendar_exam
true
count
60 respuestas
participation
0,27
avg
4,17
avg4
4,18
niebla
false
niveles 1 / 2 / 3 / 4 / 5
0 / 0 / 6 / 38 / 16
comment_count
7
Los comentarios salen de un banco fijo de 560 comentarios, también sintéticos, escritos en español rioplatense. Se repiten entre equipos: sirven para probar el flujo, no como ejemplos de lenguaje independientes.
Comparamos varios métodos sobre los 500 equipos de prueba. Mostramos dos: un modelo de gradient boosting y una regla simple que avisa cuando el promedio de la semana queda medio punto o más por debajo del promedio de las últimas cuatro. Solo se evalúan semanas con al menos 8 respuestas. “Recall” es qué parte de las semanas que anteceden a un bajón se marcaron; “falsas alarmas” se cuenta por equipo y por mes.
Tamaño grande:
Horizonte
Método
Precisión
Recall
Falsas alarmas / equipo / mes
2 semanas
Gradient boosting
38,2%
52,8%
0,23
2 semanas
Regla simple
52,1%
37,5%
0,09
4 semanas
Gradient boosting
32,3%
50,3%
0,60
4 semanas
Regla simple
57,9%
20,2%
0,08
Gradient boosting según el tamaño de entrenamiento (horizonte de 2 semanas):
Tamaño
Precisión
Recall
Falsas alarmas / equipo / mes
Chico
46,5%
39,1%
0,16
Mediano
42,8%
41,1%
0,15
Grande
38,2%
52,8%
0,23
Lo que sacamos de esto:
El modelo encuentra bastantes más bajones que la regla simple, pero a cambio de muchas más falsas alarmas. A 4 semanas, más de una falsa alarma cada dos meses por equipo es demasiado para un panel que alguien mira de verdad.
Más datos de entrenamiento suben el recall, no la precisión. Con 20.000 equipos el modelo se anima a avisar más, no a avisar mejor.
La regla simple sigue siendo una base difícil de ignorar. Cualquier alerta que pongamos en el producto tiene que ganarle con claridad, no solo en recall.
Ninguno de estos números dice qué pasaría con equipos reales. Dicen cuál método conviene probar primero cuando tengamos datos de pilotos.
El simulador usa una semilla fija y es determinista: con el mismo código y la misma semilla se obtienen exactamente los mismos archivos. Cada tamaño tiene su esquema, un manifiesto con el hash de cada archivo y un candado sobre el set de prueba, así nadie puede retocar la prueba sin que se note. Los archivos están en Parquet, partidos en piezas de menos de 10 MiB.
Por ahora el repositorio es interno, así que no hay enlace de descarga. Si investigás clima escolar o laboral y te sirve, escribinos a hola@moodinary.com.
Es un simulador. Los mecanismos (cómo cae el ánimo, quién responde, cuánto dura un bajón) los elegimos nosotros. Si están mal, un modelo que anda bien acá puede andar mal afuera.
Los tamaños de organización y la frecuencia de eventos son decisiones nuestras, no proporciones observadas en escuelas o empresas reales.
Los comentarios se repiten. Son 560 textos reutilizados; no sirven para entrenar modelos de lenguaje.
Los equipos “nulos” pueden tener bajones falsos, por cambios en quién responde. Está hecho a propósito, porque en la práctica también pasa.
Grande no es más real que chico. Solo tiene más organizaciones para entrenar; el examen es el mismo.
Cuando tengamos pilotos con permiso explícito, el plan es comparar contra esto y contar qué tan lejos estaba la simulación.
Estamos probando nubi-moderation-preview, un modelo interno que revisa comentarios de pulsos. Antes de usarlo en el producto, queríamos saber qué tan bien funciona y dónde falla. Estos son los primeros números.
Escribimos y etiquetamos 424 comentarios en español rioplatense, mezclando registro de colegio y de trabajo. Los dividimos en 212 para ajustar el modelo y 212 que guardamos aparte para la prueba final. Comentarios parecidos quedaron siempre del mismo lado, para que la prueba no sea con casos ya vistos.
Incluimos a propósito casos difíciles: respuestas cortas pero genuinas, quejas que se repiten, chistes comunes, y mensajes de angustia que usan palabras parecidas a un troll.
De 58 casos de riesgo, se le escaparon 4: una preocupación explícita por la seguridad, una amenaza inventada que el autor admitía, un caso de consumo con peligro físico, y un pedido de ayuda ambiguo. Que no haya marcado riesgo en ningún caso sano es un resultado de esta muestra, no una promesa.
Por eso, si algún día lo usamos, va a funcionar así:
Una señal de riesgo siempre va a una persona.
Marcar algo como spam nunca puede tapar una posible crisis.
Nada se borra ni se oculta automáticamente por lo que diga el modelo.
Los casos y las etiquetas los generó un asistente de IA, sin revisión humana independiente ni clínica.
El set tiene muchos más casos positivos que la vida real, así que no dice cuán seguido aparecen estas situaciones ni cómo rinde con comentarios reales.
Con pocos casos por tarea, hasta los números buenos tienen incertidumbre.
Antes de cualquier afirmación de seguridad haría falta una evaluación con datos reales y revisión independiente.
Vamos a publicar los próximos números cuando los tengamos, igual que estos.
Nubi es la nube que ves abajo a la derecha del panel. Le podés preguntar cosas como “¿cómo viene 2° B este mes?” o pedirle que te lleve a una sección.
En el seguimiento interno de un pulso, si escribís @Nubi, responde ahí mismo con lo que sabe de ese pulso.
Nubi solo ve lo que vos podés ver, y si propone un cambio te pide confirmación antes de hacerlo. Está en planes Insight y Horizon, y se apaga junto con el resto de las funciones de IA desde Ajustes → Configuración.