LACE: una arquitectura para que varios modelos se revisen entre sí
LACE no es un modelo. Es una forma de encadenar varios modelos para resolver una tarea, con revisión cruzada a ciegas y un resultado seguro por defecto. Está en evaluación.
Cuando un solo modelo resuelve una tarea delicada, sus errores pasan sin que nadie los vea. LACE es la arquitectura que estamos armando para que eso no pase: en lugar de confiar en un modelo, encadena varios y los hace revisarse entre sí.
LACE no es un modelo. Es una forma de organizar varios modelos que sirve para distintas tareas de lenguaje. El nombre viene de Layered Aggregation with Cross-model Evaluation.
Las cuatro etapas
Sección titulada «Las cuatro etapas»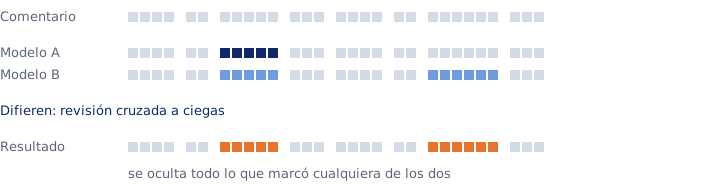
1. Extraer, por separado. Dos modelos distintos hacen la misma tarea sobre el mismo texto, cada uno por su cuenta y sin ver lo que hizo el otro. Cada uno puede combinar varias capas propias; lo que importa es que lleguen a una respuesta independiente.
2. Si coinciden, aceptar. Si las dos respuestas son exactamente iguales, se aceptan y el proceso termina ahí, sin llamadas extra.
3. Si difieren, revisión cruzada a ciegas. Cada modelo recibe las dos respuestas, llamadas solo “A” y “B” en un orden mezclado, y opina sobre cada punto: mantenerlo, descartarlo o corregirlo dentro de opciones acotadas. Junto con la opinión elige una razón de una lista cerrada. Ningún modelo sabe cuál respuesta es la suya.
4. Reconciliar una vez y caer en lo seguro. Lo que sigue en discusión vuelve a los dos modelos con la opinión y la razón del otro. Hay una sola ronda de este tipo, sin vueltas infinitas. Si no se ponen de acuerdo, gana la opción segura que se definió de antemano para esa tarea.
Además hay un piso: todo lo que cualquiera de los dos encontró en la primera etapa se respeta en el resultado final, aunque después la revisión lo descarte. Las opiniones de la revisión quedan registradas para estudiarlas, pero no pueden bajar de ese piso.
Por qué así
Sección titulada «Por qué así»Un modelo solo se equivoca de formas que no puede ver. Dos modelos distintos tienden a equivocarse en lugares distintos, así que cada uno puede encontrar lo que al otro se le pasó.
La revisión es a ciegas para que ninguno defienda su respuesta por ser suya. Mezclar el orden no garantiza que un modelo nunca reconozca su propio estilo, pero saca la ventaja más obvia.
El piso existe porque dos modelos también pueden ponerse de acuerdo en algo incorrecto. En tareas donde un error es caro, preferimos equivocarnos hacia el lado seguro y pagarlo con algo de precisión.
Primera aplicación: tapar datos personales
Sección titulada «Primera aplicación: tapar datos personales»La primera tarea donde estamos probando LACE es encontrar y tapar nombres y otros datos personales en los comentarios, con nubi-entity-preview. Ahí la opción segura es ocultar: si los modelos no se ponen de acuerdo, el dato se tapa, y todo lo que marcó cualquiera de los dos queda tapado. Lo que ninguno marca, la revisión no lo puede encontrar.
Lo que no es
Sección titulada «Lo que no es»- No es la moderación. El filtro que hoy decide si un comentario se muestra es otra cosa: automático, con tres niveles que elige cada organización (Permisivo, Cauteloso o Estricto). No hay personas leyendo comentarios para moderarlos. Tapar datos personales con LACE, si se activa, va a ser un paso aparte.
- No reemplaza la niebla. Con menos de 8 pulsos en una semana, el promedio sigue mostrándose como provisorio y sin tendencia.
En qué estado está
Sección titulada «En qué estado está»Probamos la lógica con modelos simulados y casos armados a mano: que las respuestas iguales salteen la revisión, que los desacuerdos lleguen a la segunda ronda, que no haya más de una, y que el piso se respete aunque la revisión diga lo contrario. Todo eso pasa.
Lo que falta es lo importante: correrlo con modelos reales sobre nuestro set de comentarios de prueba, que también es sintético, y medir qué encuentra, cuánto tapa de más y cuánto cuesta. Cuando lo hagamos, publicamos los números acá, buenos o malos.