Datasets sintéticos de equipos: ahora con organizaciones
Tres tamaños nuevos, de 500 a 20.000 equipos simulados agrupados en escuelas y empresas. Qué hay adentro, ejemplos reales de filas y los primeros resultados.
Para probar alertas tempranas necesitamos historias largas de muchos equipos: semanas de pulsos, bajones, vacaciones, cambios de docente. No las tenemos, y aunque las tuviéramos no usaríamos datos reales de alumnos o empleados para esto. Así que las simulamos.
Este post cuenta la segunda versión de esos datos. La novedad principal es que los equipos ya no viven solos: pertenecen a organizaciones que comparten calendario y problemas.
Qué cambió
Sección titulada «Qué cambió»La primera versión tenía 2.400 equipos, 62.055 semanas y 2.594.379 pulsos. Cada equipo era independiente de los demás.
En una escuela o una empresa eso no pasa. Si se va un docente o hay una reestructuración, varios cursos o áreas bajan a la vez. Y si al separar los datos para la prueba final un curso queda en entrenamiento y su curso hermano en prueba, el modelo “ya vio” el problema compartido y el resultado sale mejor de lo que es.
La versión 2 cambia dos cosas:
- Organizaciones. Cada equipo pertenece a una escuela o a una empresa simulada, de 1 a 48 equipos. Cada organización tiene su propio ruido semanal y puede tener eventos que la afectan entera: semana de exámenes, un docente que se va o desgaste acumulado en escuelas; despidos o reorganización y desgaste en empresas. Alrededor del 28% de las organizaciones no tiene ninguno. No todos los equipos sienten el golpe igual: la exposición de cada uno va de 0,35 a 1,45 veces la intensidad del evento.
- Separación por organización. Entrenamiento, ajuste y prueba se dividen por organización completa, nunca por equipo ni por semana.
Tres tamaños
Sección titulada «Tres tamaños»| Organizaciones | Equipos | Semanas | Pulsos | |
|---|---|---|---|---|
| Chico | 44 | 500 | 12.210 | 559.736 |
| Mediano | 184 | 2.400 | 61.946 | 2.638.210 |
| Grande | 1.284 | 20.000 | 528.356 | 21.860.803 |
Los equipos se reparten así entre entrenamiento, ajuste y prueba: 350 / 50 / 100 en el chico, 1.650 / 250 / 500 en el mediano y 17.050 / 2.450 / 500 en el grande.
Los tamaños están anidados: el chico es el comienzo exacto del mediano, y el mediano del grande. El mediano y el grande usan exactamente los mismos 500 equipos de prueba; el chico usa 100 de ellos, de 8 organizaciones que cubren todos los rangos de tamaño en escuela y en empresa. Así, si un modelo mejora del mediano al grande, es por tener más datos para entrenar y no porque cambió el examen.
Una escuela simulada
Sección titulada «Una escuela simulada»Seis cursos de la misma escuela, 39 semanas. Cada cuadrado es el promedio de una semana. En las semanas 23 a 25 la escuela tiene un evento de “docente que se va”: los seis cursos bajan a la vez, unos más que otros.
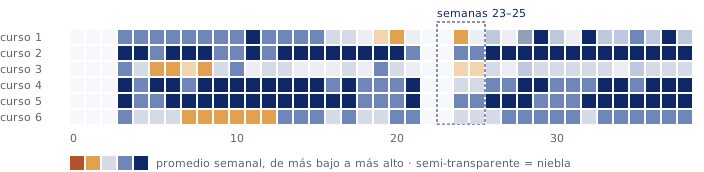
En v1 cada uno de esos bajones habría sido un caso aislado.
Qué hay adentro
Sección titulada «Qué hay adentro»Hay dos colecciones. La primera tiene los datos “crudos” en cuatro tablas, todas con org_id y org_size:
teams: un registro por equipo (tamaño, fecha de inicio, si es escuela o empresa).pulses: un registro por respuesta (nivel del 1 al 5, motivo y comentario opcional).events: los eventos del equipo o de la organización, con inicio, fin e intensidad.truth: el clima “real” escondido de cada semana y las etiquetas a predecir.
La segunda colección resume todo por equipo y semana: cantidad de respuestas, promedio, desvío, participación, si la semana quedó en niebla, distribución de niveles y motivos, promedios móviles y tendencia. Es lo que vería un panel.
Algunas columnas existen solo para evaluar y no deben usarse como entrada de un modelo: el clima escondido, los efectos asignados, la exposición a los eventos de la organización y si el equipo es “nulo” (sin cambios reales, solo ruido). Por eso los resúmenes semanales no incluyen ninguna señal de los eventos de la organización: un modelo tiene que darse cuenta solo, como pasaría en la práctica.
Las etiquetas son downturn_next_2w y downturn_next_4w: si el clima escondido va a caer en las próximas 2 o 4 semanas respecto del promedio de las cuatro anteriores.
Filas de ejemplo
Sección titulada «Filas de ejemplo»Dos pulsos, tal cual están en el archivo:
{ "team_id": "org-v2-small-train-school-0000-t000", "org_id": "org-v2-small-train-school-0000", "org_size": 1, "week_index": 0, "created_at": "2026-05-18T17:22:04-03:00", "level": 4, "reason": "COMUNIDAD", "comment": "En el optativo de programación hice que el botón cambie de color, estoy re orgulloso."}{ "team_id": "org-v2-small-train-school-0000-t000", "week_index": 0, "created_at": "2026-05-18T10:35:20-03:00", "level": 4, "reason": "FAMILIA", "comment": "En fotografía salimos a buscar reflejos y me divertí un montón."}Un evento de organización. La misma escuela tiene semana de exámenes entre las semanas 12 y 20, y cada curso recibe una copia ajustada a su exposición:
{ "team_id": "org-v2-small-train-school-0001-t000", "event_scope": "organization", "org_shock_id": "org-v2-small-train-school-0001-s00", "event_type": "exam_stress", "onset_week": 12, "end_week": 20, "severity": 0.741, "onset_date": "2026-06-08", "end_date": "2026-08-09"}Y una semana resumida de un curso de 45 alumnos (recortada, la fila completa tiene más columnas):
| Columna | Valor |
|---|---|
week_start |
2026-06-22 |
calendar_exam |
true |
count |
60 respuestas |
participation |
0,27 |
avg |
4,17 |
avg4 |
4,18 |
niebla |
false |
| niveles 1 / 2 / 3 / 4 / 5 | 0 / 0 / 6 / 38 / 16 |
comment_count |
7 |
Los comentarios salen de un banco fijo de 560 comentarios, también sintéticos, escritos en español rioplatense. Se repiten entre equipos: sirven para probar el flujo, no como ejemplos de lenguaje independientes.
Primeros resultados
Sección titulada «Primeros resultados»Comparamos varios métodos sobre los 500 equipos de prueba. Mostramos dos: un modelo de gradient boosting y una regla simple que avisa cuando el promedio de la semana queda medio punto o más por debajo del promedio de las últimas cuatro. Solo se evalúan semanas con al menos 8 respuestas. “Recall” es qué parte de las semanas que anteceden a un bajón se marcaron; “falsas alarmas” se cuenta por equipo y por mes.
Tamaño grande:
| Horizonte | Método | Precisión | Recall | Falsas alarmas / equipo / mes |
|---|---|---|---|---|
| 2 semanas | Gradient boosting | 38,2% | 52,8% | 0,23 |
| 2 semanas | Regla simple | 52,1% | 37,5% | 0,09 |
| 4 semanas | Gradient boosting | 32,3% | 50,3% | 0,60 |
| 4 semanas | Regla simple | 57,9% | 20,2% | 0,08 |
Gradient boosting según el tamaño de entrenamiento (horizonte de 2 semanas):
| Tamaño | Precisión | Recall | Falsas alarmas / equipo / mes |
|---|---|---|---|
| Chico | 46,5% | 39,1% | 0,16 |
| Mediano | 42,8% | 41,1% | 0,15 |
| Grande | 38,2% | 52,8% | 0,23 |
Lo que sacamos de esto:
- El modelo encuentra bastantes más bajones que la regla simple, pero a cambio de muchas más falsas alarmas. A 4 semanas, más de una falsa alarma cada dos meses por equipo es demasiado para un panel que alguien mira de verdad.
- Más datos de entrenamiento suben el recall, no la precisión. Con 20.000 equipos el modelo se anima a avisar más, no a avisar mejor.
- La regla simple sigue siendo una base difícil de ignorar. Cualquier alerta que pongamos en el producto tiene que ganarle con claridad, no solo en recall.
Ninguno de estos números dice qué pasaría con equipos reales. Dicen cuál método conviene probar primero cuando tengamos datos de pilotos.
Cómo está armado
Sección titulada «Cómo está armado»El simulador usa una semilla fija y es determinista: con el mismo código y la misma semilla se obtienen exactamente los mismos archivos. Cada tamaño tiene su esquema, un manifiesto con el hash de cada archivo y un candado sobre el set de prueba, así nadie puede retocar la prueba sin que se note. Los archivos están en Parquet, partidos en piezas de menos de 10 MiB.
Por ahora el repositorio es interno, así que no hay enlace de descarga. Si investigás clima escolar o laboral y te sirve, escribinos a hola@moodinary.com.
Límites
Sección titulada «Límites»- Es un simulador. Los mecanismos (cómo cae el ánimo, quién responde, cuánto dura un bajón) los elegimos nosotros. Si están mal, un modelo que anda bien acá puede andar mal afuera.
- Los tamaños de organización y la frecuencia de eventos son decisiones nuestras, no proporciones observadas en escuelas o empresas reales.
- Los comentarios se repiten. Son 560 textos reutilizados; no sirven para entrenar modelos de lenguaje.
- Los equipos “nulos” pueden tener bajones falsos, por cambios en quién responde. Está hecho a propósito, porque en la práctica también pasa.
- Grande no es más real que chico. Solo tiene más organizaciones para entrenar; el examen es el mismo.
Cuando tengamos pilotos con permiso explícito, el plan es comparar contra esto y contar qué tan lejos estaba la simulación.